KURZ ERKLÄRT
Robots.txt steuert den Zugriff kooperierender Crawler auf URL-Bereiche. Behandelt die Datei als versionierte technische Richtlinie mit klaren Zielen und Tests. Sie schützt keine vertraulichen Informationen und ersetzt keine Indexierungsentscheidung. Ein gutes Regelwerk hält gewünschte Inhalte zugänglich, begrenzt unnötige Abrufe und bleibt für das Team verständlich.
Wie technische Grundlagen, hilfreiche Inhalte und Sichtbarkeitsmessung zusammenhängen, zeigt der übergeordnete Guide SEO, GEO und AEO für SaaS: Sichtbarkeit, die Kaufentscheidungen unterstützt.
Zweck und Geltungsbereich festlegen
Erfasst zunächst alle öffentlich erreichbaren Hosts und Umgebungen. Die Regeln einer Domain gelten nicht automatisch für jede andere Domain oder jedes Subdomain-Angebot. Notiert, wer die jeweilige Datei ausliefert und ob CMS, CDN oder Anwendung sie verändern. Unterscheidet Produktionswebsite, Dokumentationsportal und Testumgebung. Eine zentrale Übersicht verhindert, dass das Marketing nur die Hauptseite prüft, während ein separater Dokumentationshost unbeabsichtigt offen oder blockiert bleibt. Verknüpft jede Regel mit einem konkreten Zweck.
Aus Absichten überprüfbare Regeln machen
Schreibt zuerst eine kleine Entscheidungstabelle: welcher Crawler, welcher Pfad, welches gewünschte Verhalten? Erst danach übersetzt ihr diese Absicht in Syntax. Prüft dabei Groß- und Kleinschreibung, Pfadgrenzen und spezifische Ausnahmen anhand der jeweiligen Plattformdokumentation. Ein Kommentar sollte erklären, warum die Regel existiert. Vermeidet gewachsene Blöcke ohne Eigentümer. Wenn niemand den ursprünglichen Zweck kennt, untersucht reale Zugriffe und Anwendungsfunktionen, bevor ihr eine alte Sperre löscht oder unkritisch auf neue Bereiche ausweitet.
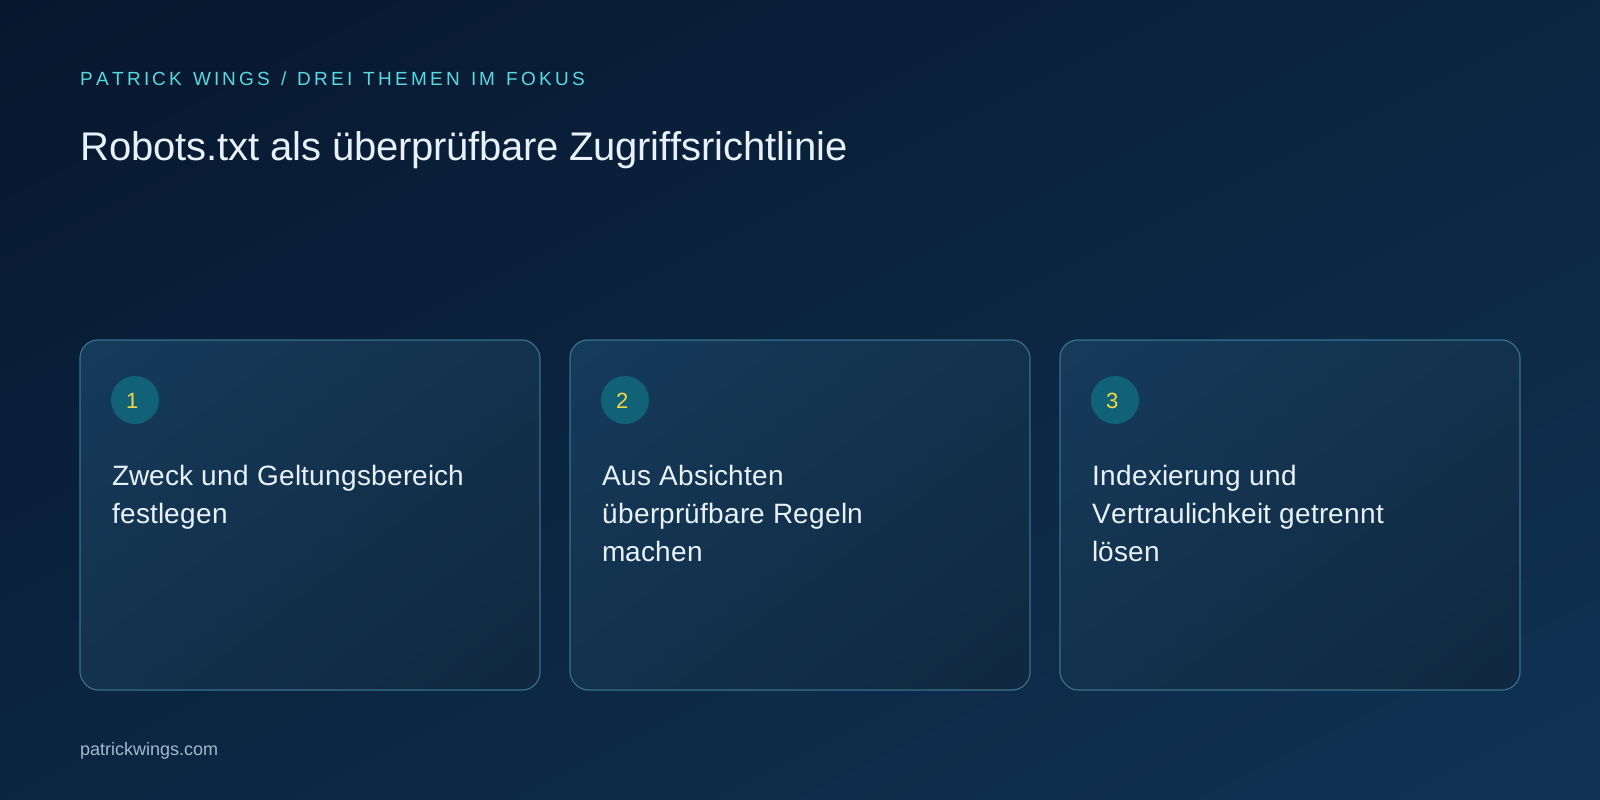
Indexierung und Vertraulichkeit getrennt lösen
Eine blockierte URL kann weiterhin über externe Links bekannt sein und gegebenenfalls als URL in Suchergebnissen erscheinen. Wenn eine öffentliche Seite nicht indexiert werden soll, braucht sie eine geeignete und abrufbare Indexierungsanweisung. Wenn Inhalte privat sind, braucht ihr Authentifizierung oder eine andere echte Zugriffssperre. Diese Trennung ist besonders für interne Kundenhandbücher und Testberichte wichtig. Eine robots.txt-Datei ist öffentlich lesbar und sollte daher niemals als Verzeichnis verborgener vertraulicher Ressourcen betrachtet werden.
Ressourcen und Templates mitprüfen
Testet nicht nur Dokumentadressen, sondern auch benötigte Skripte, Stylesheets und Bilder. Eine pauschale Sperre eines Assetverzeichnisses kann die Verarbeitung öffentlicher Seiten beeinträchtigen. Untersucht repräsentative Templates mit ihren tatsächlichen Abhängigkeiten. Prüft außerdem, ob eure Sicherheitslösung erlaubte Botzugriffe trotzdem mit Challenges oder Fehlerseiten beantwortet. Eine korrekte robots.txt-Datei allein beweist keine technische Erreichbarkeit. Dokumentiert deshalb getrennt die Richtlinie und das beobachtete Ergebnis eines konkreten Abrufs durch eine geeignete Prüfmethode. Mehr dazu im Leitfaden KI-Suchcrawler und Trainingscrawler getrennt steuern.

Ein hypothetisches Dokumentationsportal absichern
Ein fiktiver Softwareanbieter möchte öffentliche Integrationsanleitungen auffindbar halten und interne Vorschauen schützen. Das Team setzt Authentifizierung für Vorschauen ein und verwendet robots.txt nur für unnötige öffentliche Suchvarianten. Es prüft explizit, dass die Integrationsseiten und ihre Skripte weiterhin erreichbar sind. Ein Testprotokoll enthält erlaubte und gesperrte Beispielpfade. Dieses hypothetische Szenario zeigt die Aufgabenteilung zwischen Sicherheit und Crawling; es belegt weder einen Sichtbarkeitsgewinn noch ein bestimmtes Verhalten sämtlicher fremder Bots.
Änderungen wie technische Releases behandeln
Speichert die bisherige Fassung und ergänzt vor einer Änderung positive sowie negative Testfälle. Ein positiver Fall bestätigt beispielsweise den Zugriff auf die wichtigste Leistungsseite; ein negativer Fall prüft eine bewusst ausgeschlossene Filterfamilie. Kontrolliert nach dem Deployment die tatsächlich ausgelieferte Datei über den öffentlichen Host. Achtet auf Weiterleitungen, Fehlercodes und eventuell zwischengespeicherte Fassungen. Notiert Zeitpunkt, Verantwortlichen und Rückrollweg. So kann das Team bei unerwarteten Zugriffsausfällen gezielt reagieren, statt mehrere Systeme gleichzeitig auf Verdacht zu verändern. Mehr dazu im Leitfaden Noindex, Robots und Canonical richtig unterscheiden.
Regelmäßig gegen die reale Architektur prüfen
Plant eine erneute Prüfung nach neuen Sprachbereichen, einem CDN-Wechsel oder einem größeren Relaunch. Vergleicht die Absicht jeder Regel mit aktuellen URL-Mustern. Entfernt überholte Kommentare und ergänzt neue Zuständigkeiten. Bewertet die Qualität nicht nach der Zahl der Sperren, sondern nach klaren Entscheidungen und funktionierenden Tests. Prüft Plattformdokumentationen erneut, wenn weitere Crawler aufgenommen werden. Suchcrawler und Trainingscrawler können getrennte Kennungen besitzen; übernimmt deshalb keine undifferenzierte KI-Sperre aus einer fremden Website ohne eigene Prüfung.
INTERAKTIV / VOM LESEN ZUR ANWENDUNG
Drei Prüfpunkte für eure Umsetzung
Wähle einen Punkt und halte deinen persönlichen Lesefortschritt fest. Die Häkchen werden weder gespeichert noch übertragen und sind keine Bewertung eures Unternehmens.
PRÜFPUNKT 01
Indexierung und Vertraulichkeit getrennt lösen
Eine blockierte URL kann weiterhin über externe Links bekannt sein und gegebenenfalls als URL in Suchergebnissen erscheinen.
Im Artikel vertiefen ↗PRÜFPUNKT 02
Ressourcen und Templates mitprüfen
Testet nicht nur Dokumentadressen, sondern auch benötigte Skripte, Stylesheets und Bilder.
Im Artikel vertiefen ↗PRÜFPUNKT 03
Ein hypothetisches Dokumentationsportal absichern
Ein fiktiver Softwareanbieter möchte öffentliche Integrationsanleitungen auffindbar halten und interne Vorschauen schützen.
Im Artikel vertiefen ↗Häufige Fragen
Verhindert robots.txt jede Indexierung?
Nein. Eine URL kann auch ohne Inhaltsabruf bekannt bleiben.
Kann robots.txt vertrauliche Dokumente schützen?
Nein. Vertrauliche Dokumente benötigen eine echte Zugriffskontrolle. Prüft die Authentifizierung unabhängig von den Regeln, die ihr für öffentliche Crawler festlegt.
Wann sollten wir Regeln erneut testen?
Nach Änderungen an Regeln, URL-Struktur, Hosting oder Sicherheitsfiltern.
Wie lässt sich „Zweck und Geltungsbereich festlegen“ praktisch umsetzen?
Erfasst zunächst alle öffentlich erreichbaren Hosts und Umgebungen. Die Regeln einer Domain gelten nicht automatisch für jede andere Domain oder jedes Subdomain-Angebot. Notiert, wer die jeweilige Datei ausliefert und ob CMS, CDN oder Anwendung sie verändern.
Was ist bei „Aus Absichten überprüfbare Regeln machen“ besonders wichtig?
Schreibt zuerst eine kleine Entscheidungstabelle: welcher Crawler, welcher Pfad, welches gewünschte Verhalten? Erst danach übersetzt ihr diese Absicht in Syntax. Prüft dabei Groß- und Kleinschreibung, Pfadgrenzen und spezifische Ausnahmen anhand der jeweiligen Plattformdokumentation.