KURZ ERKLÄRT
Ein Fragenpanel ist eine festgelegte Auswahl realitätsnaher Fragen, die unter dokumentierten Bedingungen wiederholt getestet wird. Es zeigt Beobachtungen für diese Auswahl und keinen vollständigen Marktanteil in KI-Antworten. Der folgende Protokollvorschlag hilft euch, Tests vergleichbar zu halten und Änderungen nicht vorschnell als Wirkung einer einzelnen Maßnahme zu deuten.
Wie technische Grundlagen, hilfreiche Inhalte und Sichtbarkeitsmessung zusammenhängen, zeigt der übergeordnete Guide SEO, GEO und AEO für SaaS: Sichtbarkeit, die Kaufentscheidungen unterstützt.
Fragen aus echten Aufgaben ableiten
Beginnt mit Käufergesprächen, Supportfällen und konkreten Rechercheaufgaben. Unterscheidet allgemeine Problemfragen, Methodenvergleiche und anbieterspezifische Fragen. Eine Sammlung ausschließlich markennaher Formulierungen kann Sichtbarkeit vorteilhaft erscheinen lassen, obwohl sie wenig über neue Entdeckung aussagt. Legt Kategorien, Auswahlgrund und bewusst ausgeschlossene Aufgaben fest. Deutsche und englische Fragen sollten dieselbe Aufgabe prüfen, müssen aber keine wortgetreuen Übersetzungen sein. Bewahrt ihre exakten Formulierungen mit stabilen Kennungen auf. Wenn eine Frage später geändert wird, entsteht eine neue Version. Sonst kann ein verändertes Ergebnis fälschlich als Veränderung des Systems oder eurer Website interpretiert werden. Mehr dazu im Leitfaden KI-Testfälle aufbauen: Aus echten Fehlern eine Prüfsammlung machen.
Testbedingungen vor dem Lauf definieren
Notiert Plattform, sichtbares Modell beziehungsweise Modus, Sprache, Datum und relevante Kontoeinstellungen. Definiert, ob neue Sitzungen verwendet werden und ob vorheriger Gesprächskontext ausgeschlossen ist. Prüft möglichst gleiche Bedingungen, erkennt aber an, dass nicht alle Plattformfaktoren kontrollierbar sind. Auch Standort und Personalisierung können die Vergleichbarkeit begrenzen. Dokumentiert, welche Bedingungen bekannt sind und welche nicht. Ändert das Protokoll nicht während eines Laufs, nur weil einzelne Antworten unpassend erscheinen. Wenn ein technisches Problem einen Test verhindert, markiert den Ausfall getrennt, statt ihn als negative Markenerwähnung in denselben Nenner einzurechnen.
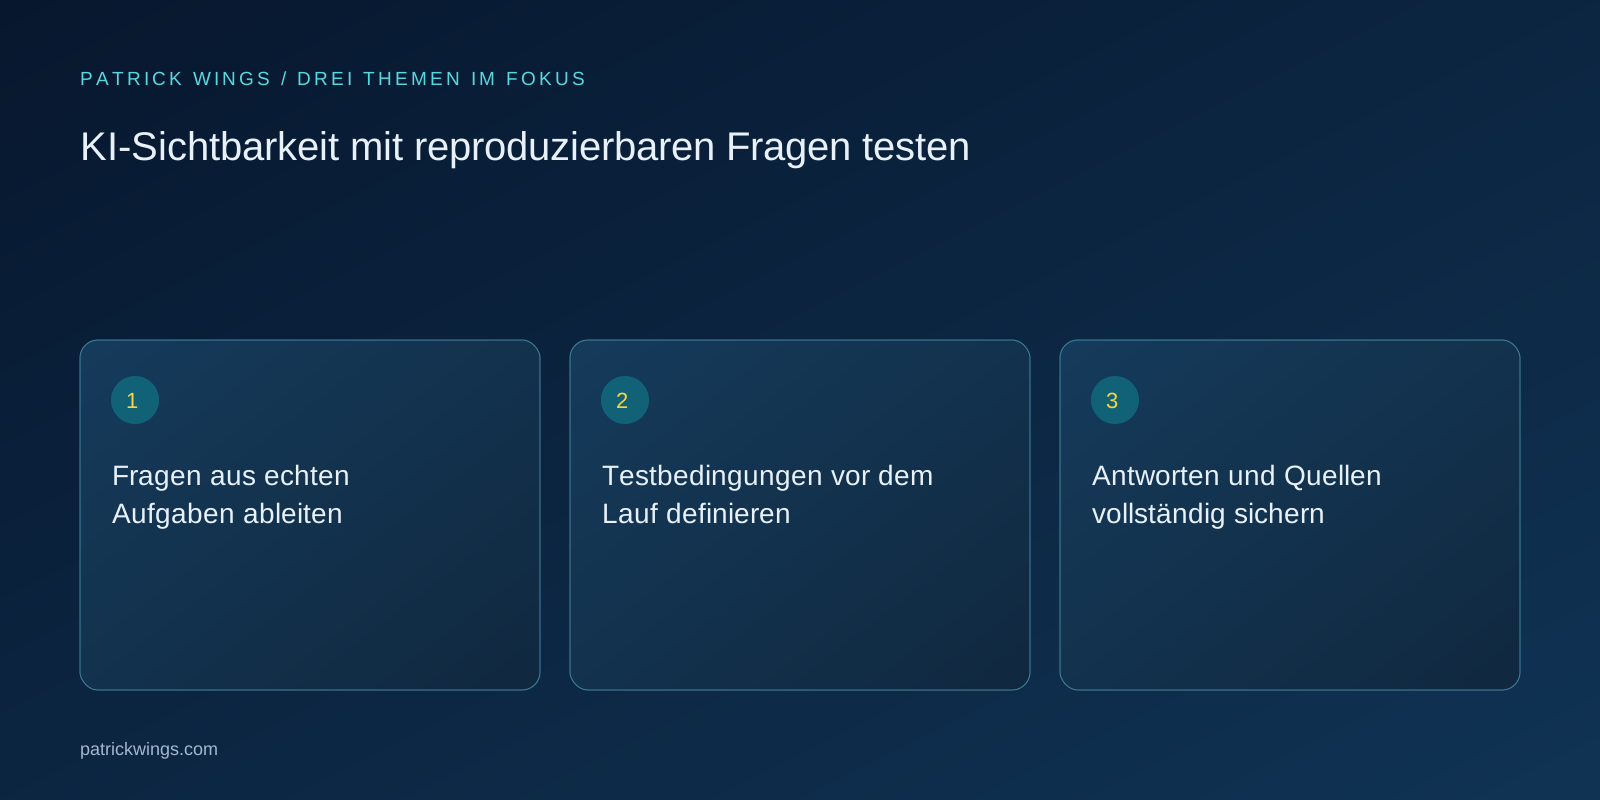
Antworten und Quellen vollständig sichern
Speichert die vollständige Antwort mit Fragekennung, Zeitpunkt und sichtbaren Quellenlinks. Ein Screenshot allein kann Links oder ausgeklappte Hinweise verbergen. Bewahrt deshalb geeignete Text- und Linkinformationen zusätzlich auf. Führt Wiederholungen nach einem vorher festgelegten Plan durch, statt nur günstige Antworten zu sammeln. Beschreibt die Anzahl gültiger Läufe je Frage und Plattform. Beachtet die Nutzungsbedingungen und zulässigen Wege der jeweiligen Systeme. Der Zweck ist eine kleine nachvollziehbare Beobachtung, kein unkontrolliertes Massenabfragen. Vermeidet personenbezogene oder vertrauliche Informationen in den Testfragen; reale Käuferaufgaben lassen sich meist ohne Kundennamen und interne Projektdetails formulieren.
Ein konsistentes Auswertungsschema verwenden
Definiert vorab, was als Markenerwähnung, Quellenlink, richtige Leistungszuordnung und sachlicher Fehler zählt. Diese Ereignisse sind unterschiedlich: Ein Name ohne Link ist keine Zitation, und eine Zitation kann einen falschen Satz begleiten. Lasst schwierige Fälle anhand derselben Kriterien durch eine zweite Person prüfen. Haltet Meinungsunterschiede fest und verbessert bei Bedarf das Schema für den nächsten Lauf. Veröffentlicht keine unklare zusammengesetzte Punktzahl als objektiven Sichtbarkeitswert. Wenn ihr zusammenfasst, zeigt die zugrunde liegenden Kategorien und Nenner. So bleibt erkennbar, ob eine Veränderung auf mehr Links, passendere Antworten oder lediglich andere Markennennungen zurückgeht.

Beispiel: Vergleichbare statt perfekte Wiederholungen
Ein hypothetisches Beratungsteam erstellt ein Panel aus konkreten SaaS-Marketingfragen. Es prüft deutsche und englische Aufgaben getrennt in festgelegten Modi und speichert jeden gültigen Lauf. Bei einer Wiederholung liefert eine Plattform andere Quellen, während die fachliche Antwort ähnlich bleibt. Das Team dokumentiert diese Variation statt nur den besseren Lauf zu zeigen. Ein Anbieterupdate wird als Kontext notiert. Das Panel erlaubt jetzt eine nachvollziehbare Diskussion über bestimmte Fragen. Es beweist weder vollständige Sichtbarkeit bei allen Nutzern noch einen kausalen Erfolg der letzten Textänderung. Die Grenzen gehören unmittelbar neben die Ergebnisdarstellung, damit sie bei Weitergabe erhalten bleiben.
Das Panel versioniert weiterentwickeln
Behaltet einen stabilen Kern für Zeitvergleiche und ergänzt neue Aufgaben als klar bezeichnete Erweiterung. Ein verändertes Fragenverhältnis kann eine Gesamtquote verschieben, ohne dass sich Antworten auf identische Fragen ändern. Vergleicht deshalb auch die gleichen Einzelkennungen. Trennt Panelbeobachtungen von Websitebesuchen und CRM-Ergebnissen. Google erläutert für seine KI-Suchfunktionen, dass Ergebnisse und Links variieren können und keine Ausspielung garantiert ist. Das unterstützt eine vorsichtige Interpretation; es macht das vorgeschlagene Panel nicht zu einem offiziell standardisierten Messverfahren. Sein Wert liegt in dokumentierten Bedingungen, reproduzierbarer Auswertung und einer ehrlichen Beschreibung dessen, was tatsächlich beobachtet wurde. Mehr dazu im Leitfaden GEO-Maßnahmen mit vorsichtigen Experimenten bewerten.
INTERAKTIV / VOM LESEN ZUR ANWENDUNG
Drei Prüfpunkte für eure Umsetzung
Wähle einen Punkt und halte deinen persönlichen Lesefortschritt fest. Die Häkchen werden weder gespeichert noch übertragen und sind keine Bewertung eures Unternehmens.
PRÜFPUNKT 01
Antworten und Quellen vollständig sichern
Speichert die vollständige Antwort mit Fragekennung, Zeitpunkt und sichtbaren Quellenlinks.
Im Artikel vertiefen ↗PRÜFPUNKT 02
Ein konsistentes Auswertungsschema verwenden
Definiert vorab, was als Markenerwähnung, Quellenlink, richtige Leistungszuordnung und sachlicher Fehler zählt.
Im Artikel vertiefen ↗PRÜFPUNKT 03
Beispiel: Vergleichbare statt perfekte Wiederholungen
Ein hypothetisches Beratungsteam erstellt ein Panel aus konkreten SaaS-Marketingfragen.
Im Artikel vertiefen ↗Häufige Fragen
Misst das Panel meinen gesamten KI-Marktanteil?
Nein. Es beschreibt die ausgewählten Fragen unter den dokumentierten Testbedingungen.
Warum braucht es wiederholte Läufe?
Antworten und Quellen können variieren. Wiederholungen machen diese Variation sichtbar.
Sind Erwähnungen und Zitationen identisch?
Nein. Erfasst Namen, Links und sachliche Richtigkeit als getrennte Kategorien.
Wie lässt sich „Fragen aus echten Aufgaben ableiten“ praktisch umsetzen?
Beginnt mit Käufergesprächen, Supportfällen und konkreten Rechercheaufgaben. Unterscheidet allgemeine Problemfragen, Methodenvergleiche und anbieterspezifische Fragen. Eine Sammlung ausschließlich markennaher Formulierungen kann Sichtbarkeit vorteilhaft erscheinen lassen, obwohl sie wenig über neue Entdeckung aussagt.
Was ist bei „Testbedingungen vor dem Lauf definieren“ besonders wichtig?
Notiert Plattform, sichtbares Modell beziehungsweise Modus, Sprache, Datum und relevante Kontoeinstellungen. Definiert, ob neue Sitzungen verwendet werden und ob vorheriger Gesprächskontext ausgeschlossen ist. Prüft möglichst gleiche Bedingungen, erkennt aber an, dass nicht alle Plattformfaktoren kontrollierbar sind.