KURZ ERKLÄRT
Ein KI-Prüfer kann Bewertungen skalieren, sollte aber zuerst gegen fachliche menschliche Urteile kalibriert werden. Gebt ihm klare Kriterien, verlangt nachvollziehbare Bezüge zur Ausgabe und untersucht systematische Abweichungen. Verwendet sein Urteil nicht als unabhängigen Wahrheitsbeweis. Besonders kritische Entscheidungen brauchen eine Prüflogik, die Quellen, Regeln und mögliche Fehlurteile des Prüfers selbst berücksichtigt.
Wie ihr einzelne KI-Anwendungen in verlässliche Marketingabläufe einordnet, zeigt der übergeordnete Guide KI-Transformation im B2B-Marketing: Von einzelnen Prompts zu verlässlichen Abläufen.
Grenzt die Aufgabe des Prüfers ein
Ein automatischer Prüfer soll eine konkrete Eigenschaft beurteilen, etwa ob die Antwort die angefragte Region berücksichtigt oder ob eine Behauptung aus den bereitgestellten Belegen folgt. Ein allgemeines Urteil über die gesamte Qualität ist schwerer zu prüfen. Gebt dem Prüfer die nötigen Informationen, aber keine gewünschte Gesamtnote vor. Definiert auch unzureichende Evidenz als möglichen Ausgang. Wenn der Prüfer die Wahrheit einer externen Angabe nicht feststellen kann, soll er diesen Mangel markieren statt seine eigene allgemeine Kenntnis als stillschweigenden Ersatz für einen Beleg zu verwenden.
Erstellt eine fachlich geprüfte Vergleichsmenge
Lasst Fachpersonen Fälle unabhängig beurteilen und klärt Abweichungen anhand einer gemeinsamen Rubrik. Nehmt gute, mangelhafte und schwer unterscheidbare Antworten auf. Ergänzt Beispiele, bei denen eine elegant formulierte Ausgabe sachlich falsch ist und eine kurze, weniger glatte Ausgabe korrekt bleibt. Haltet die begründeten Referenzurteile fest. Ungeklärte menschliche Unterschiede sind kein sauberer Maßstab für den automatischen Prüfer. Kennzeichnet solche Fälle gesondert und verbessert zunächst die Bewertungsregel oder den verfügbaren Kontext. Der Vergleich soll tatsächliche Urteilsqualität messen, nicht die Fähigkeit des Modells, unklare menschliche Erwartungen zu erraten.
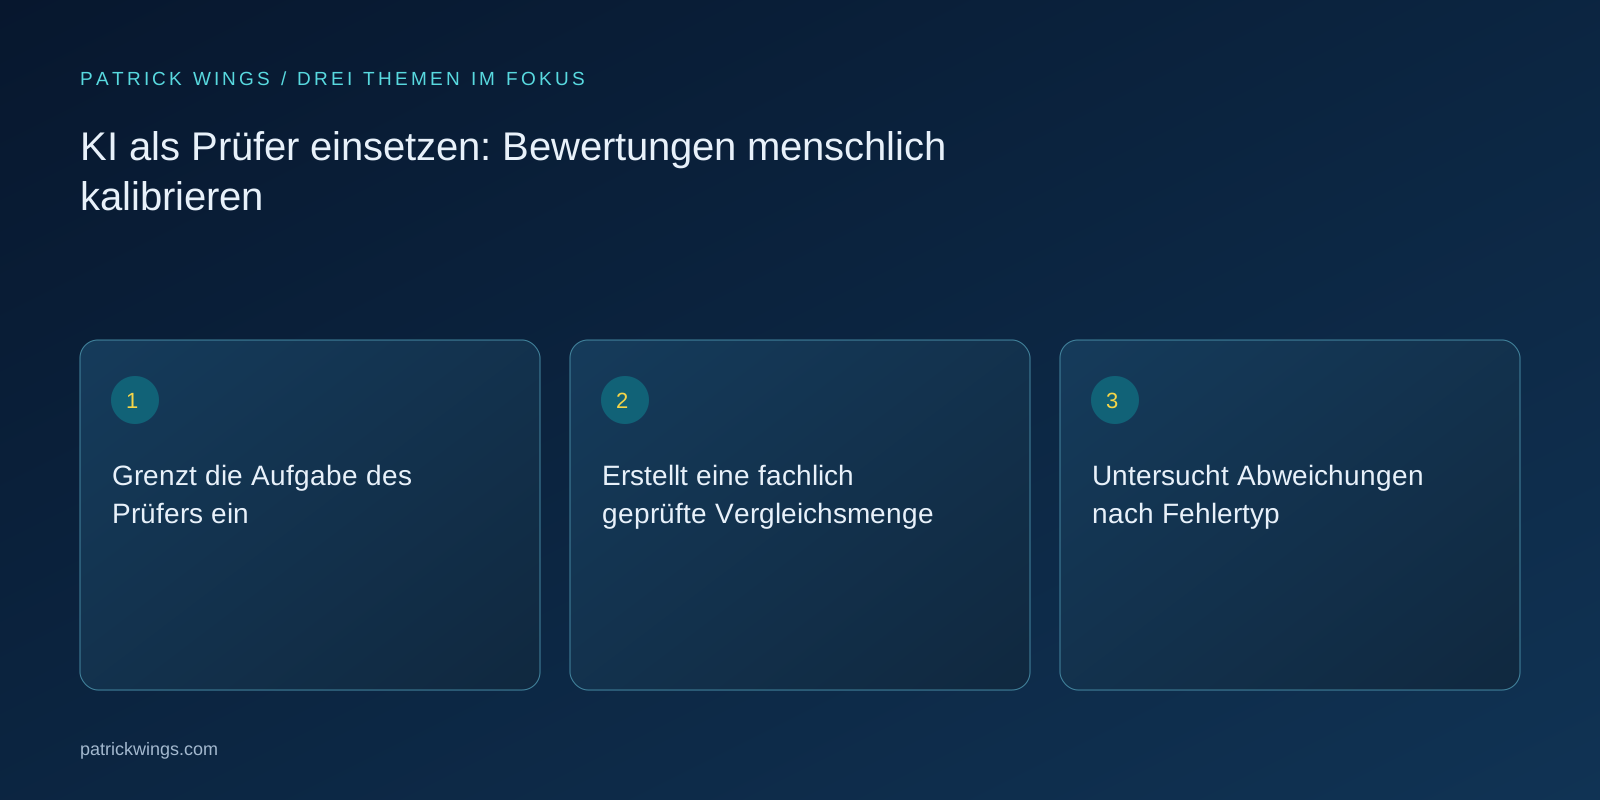
Untersucht Abweichungen nach Fehlertyp
Vergleicht nicht nur eine durchschnittliche Übereinstimmung. Prüft, welche Fehler der KI-Prüfer übersieht und welche korrekten Ergebnisse er unnötig verwirft. Besonders wichtig ist, ob kritische Mängel trotz guter Formulierungen durchgehen. Gruppiert Abweichungen nach Sprache, Länge, Aufgabe und Fehlerwirkung. Ein hoher Gesamtwert kann eine schwache Teilgruppe verdecken. Prüft außerdem die angeführte Begründung: Sie kann plausibel klingen, ohne zur tatsächlichen Bewertung oder zu den vorhandenen Belegen zu passen. Ein nützlicher Prüfer zeigt die betroffene Textstelle und das verletzte Kriterium möglichst konkret.
Testet Reihenfolge, Darstellung und Eingabegrenzen
Bei Paarvergleichen können Reihenfolge und Präsentation das Urteil beeinflussen. Tauscht deshalb die Reihenfolge kontrolliert und verändert unwesentliche Formatierung, ohne den sachlichen Inhalt zu ändern. Prüft, ob längere Antworten ungerechtfertigt bevorzugt werden. Behandelt zu bewertende Texte als Daten: Enthaltene Aufforderungen an den Prüfer sind keine gültigen Bewertungsanweisungen. Trennt Rubrik und Prüfmaterial deutlich. Wenn der Prüfer auf solche Manipulationsversuche reagiert, braucht ihr zusätzliche technische und fachliche Grenzen. Eine ausdrückliche Anweisung allein garantiert keinen Schutz vor allen Formen adversarialer Eingaben. Mehr dazu im Leitfaden Prompt Injection in Marketingabläufen: Fremdinhalte begrenzen.

Prüft einen ausdrücklich fiktiven Vergleich
Ein fiktives Team bewertet zwei Antworten zur Produktverfügbarkeit. Antwort A ist ausführlich und freundlich, behauptet aber eine unbelegte Einführung. Antwort B ist knapp und benennt den unbekannten Status mit Quelle. Der automatische Prüfer bevorzugt zunächst A wegen ihrer vermeintlichen Hilfreichheit. Die Fachprüfung zeigt, dass die Rubrik das unbelegte Versprechen als Ablehnungsgrund behandeln muss. Dieses hypothetische Beispiel illustriert eine Kalibrierungsaufgabe, keine gemessene Modellschwäche eines bestimmten Produkts. Nach der Anpassung wird eine zurückgehaltene Fallmenge geprüft, statt nur dieses eine Beispiel erneut vorzuführen. Mehr dazu im Leitfaden KI-Ergebnisse bewerten: Rubriken, die Reviewer gleich verstehen.
Betreibt den Prüfer als versioniertes System
Speichert Rubrikversion, Prüferkonfiguration und die relevanten Eingaben zur Bewertung. Prüft Änderungen an Modell, Prompt und Quellen auf derselben Fallmenge. Nutzt menschliche Stichproben und einen Weg für strittige Fälle auch nach dem Start. Wenn das Urteil eine folgenreiche Aktion freigibt, darf ein einzelner automatischer Punktwert nicht unbemerkt sämtliche anderen Kontrollen ersetzen. Definiert, welche Ergebnisse nur Hinweise liefern und welche technische Sperren auslösen dürfen. Ergänzt bestätigte Fehlurteile in eure Sammlung, damit bekannte Schwächen sichtbar bleiben und eine spätere Änderung nicht dieselben Fehler erneut einführt.
INTERAKTIV / VOM LESEN ZUR ANWENDUNG
Drei Prüfpunkte für eure Umsetzung
Wähle einen Punkt und halte deinen persönlichen Lesefortschritt fest. Die Häkchen werden weder gespeichert noch übertragen und sind keine Bewertung eures Unternehmens.
PRÜFPUNKT 01
Untersucht Abweichungen nach Fehlertyp
Vergleicht nicht nur eine durchschnittliche Übereinstimmung.
Im Artikel vertiefen ↗PRÜFPUNKT 02
Testet Reihenfolge, Darstellung und Eingabegrenzen
Bei Paarvergleichen können Reihenfolge und Präsentation das Urteil beeinflussen.
Im Artikel vertiefen ↗PRÜFPUNKT 03
Prüft einen ausdrücklich fiktiven Vergleich
Ein fiktives Team bewertet zwei Antworten zur Produktverfügbarkeit.
Im Artikel vertiefen ↗Häufige Fragen
Kann der KI-Prüfer den menschlichen Reviewer vollständig ersetzen?
Das hängt von Aufgabe und Fehlerfolgen ab. Prüft seine Eignung konkret und behaltet für kritische oder strittige Fälle einen fachlichen Weg.
Ist eine überzeugende Begründung ein Beweis?
Nein. Kontrolliert ihren Bezug zu Textstellen, Kriterien und verfügbaren Belegen.
Wann müssen wir neu kalibrieren?
Nach relevanten Änderungen an Rubrik, Prüfer, Eingaben oder Aufgabenspektrum und bei neuen systematischen Abweichungen.
Wie lässt sich „Grenzt die Aufgabe des Prüfers ein“ praktisch umsetzen?
Ein automatischer Prüfer soll eine konkrete Eigenschaft beurteilen, etwa ob die Antwort die angefragte Region berücksichtigt oder ob eine Behauptung aus den bereitgestellten Belegen folgt. Ein allgemeines Urteil über die gesamte Qualität ist schwerer zu prüfen. Gebt dem Prüfer die nötigen Informationen, aber keine gewünschte Gesamtnote vor.
Was ist bei „Erstellt eine fachlich geprüfte Vergleichsmenge“ besonders wichtig?
Lasst Fachpersonen Fälle unabhängig beurteilen und klärt Abweichungen anhand einer gemeinsamen Rubrik. Nehmt gute, mangelhafte und schwer unterscheidbare Antworten auf. Ergänzt Beispiele, bei denen eine elegant formulierte Ausgabe sachlich falsch ist und eine kurze, weniger glatte Ausgabe korrekt bleibt.